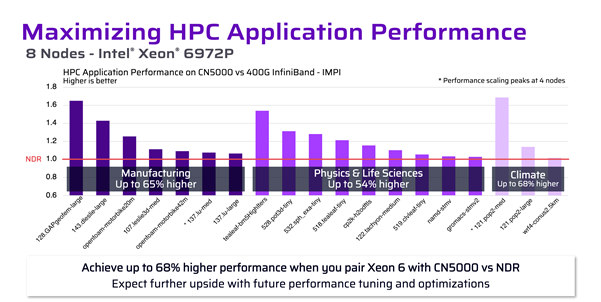
Det är där Cornelis CN5000 Omni-Path® och Hammer’s HPC-lösningsdesign och leverans passar ihop: ett nätverk konstruerat för att förbli förutsägbart under tung belastning, kombinerat med ett tillvägagångssätt som hjälper europeiska organisationer att designa, validera, driftsätta och stödja den arkitektur som matchar deras applikationer.
Vad har förändrats inom europeisk forskningsberäkning och varför nätverksstrukturen är viktigare än någonsin
Fysik och livsvetenskaper träffar båda på liknande tryckpunkter:
- Storskaliga MPI-kollektiv (allreduce/alltoall), känsliga för tail-latens
- Många små meddelanden där meddelandefrekvensen är lika viktig som bandbredden
- Incast- och burstig trafik (vanligt vid AI-träning, rekonstruktion och analysblandningar)
- Synkroniseringstung simulering där jitter blir till bortkastad beräkningstid
När ett nätverk blir överbelastat eller introducerar långa fördröjningar ser du att utnyttjandet kollapsar - dyra acceleratorer sitter overksamma och väntar på nästa batch eller kollektiv att slutföras.
CN5000 i klartext: vad det är och vad det är utformat för att åtgärda
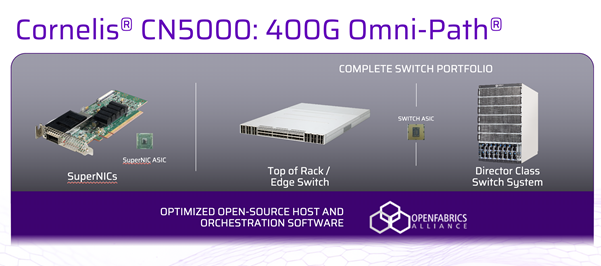
Cornelis CN5000 Omni-Path är en skalbar nätverksplattform avsedd för AI- och HPC-miljöer där hög genomströmning och stabil prestanda krävs, även när systemet är belastat.
Några praktiska punkter som är viktiga för HPC-team:
- 400G per port-omkoppling (CN5000-switchar refereras vanligen som 48-portars 400G-klass, vilket levererar mycket hög aggregerad bandbredd per switch)
- Mycket hög paketbearbetningskapacitet (kritisk för HPC-trafik med små meddelanden)
- En designfokus på att undvika prestandaklippor genom förlustfritt beteende, hantering av fabric-överbelastning, multipath-routning och robust flödeskontroll
Kärnidén: håll kommunikationen förutsägbar när klustret är fullt av riktiga jobb, inte bara när man kör idealiserade tester på ett tyst nätverk.
Där Hammer passar för att omvandla CN5000:s kapacitet till en distribuerbar europeisk lösning
CN5000 är fabric-tekniken. Hammers värde är att få den att fungera i verkligheten – att balansera prestandamål med upphandlingsbegränsningar, tidsplaner, platsstandarder och operativ beredskap.
I praktiken innebär det vanligtvis:
- Översätta applikationsbehov (MPI, AI-träning, pipeline-analys) till en skalbar fabric-design
- -Validera prestanda med rätt tester (inte bara leverantörens standardriktmärken
- Leverera en integrerad lösning:
- Växling
- Kabeldragning
- Värdanslutning
- Konfiguration
- Utrullningsstöd
- Hjälpa team att operationalisera:
- Övervakning
- Ändringskontroll
- Reservdelsstrategi
- Supportmönster för dag två
Jämförelsetabell: CN5000 vs vanliga HPC/AI-interconnect-metoder
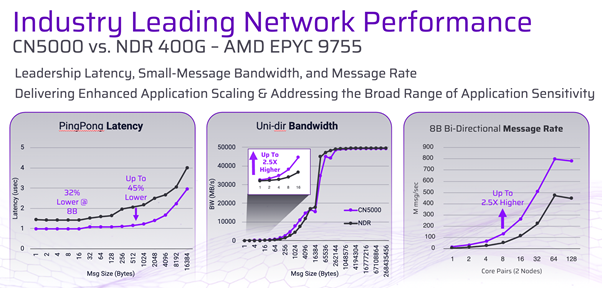
Den “bästa” sammankopplingen beror på arbetsbelastning, skala och operativa preferenser. Tabellen nedan är en praktisk jämförelse på arkitekturnivå som du kan använda i tidiga design diskussioner.
|
Kriterium |
Cornelis CN5000 Omni-Path |
InfiniBand (moderna generationer) |
Ethernet (RoCE / högpresterande Ethernet) |
|
Primärt designmål |
AI + HPC-skalning med förutsägbara sluttider under belastning |
HPC/AI-skalning, allmänt använd i toppmodern HPC |
Bred datacenter- + AI/HPC-miljö där standardanpassning och gemensamma verktyg är nyckeln |
|
Beteende vid överbelastning |
Byggd för att minimera påverkan av överbelastning och hålla prestandan stabil (förlustfri fabric-avsikt) |
Starka alternativ beroende på konfiguration och trängselkontroll |
Kan vara utmärkt, men tenderar att vara mer känslig för korrekt justering (PFC/ECN, buffring, QoS) |
|
Känslighet för svanslatens |
Generellt optimerad för låg latens och meddelandehastighet |
Generellt mycket stark för låg latens och kollektiv |
Kan vara konkurrenskraftigt, men svanslatens kan försämras vid felkonfigurering eller överteckning |
|
Operativ komplexitet |
HPC-fokuserad verktygslåda och modell; vanligtvis mer “fabric-first” |
Mogen ekosystem; starka operativa mönster inom HPC |
Välbekant för nätverksteam, men “HPC-grade RoCE” kräver vanligtvis noggrann designdisciplin |
|
Ekosystem och integration |
Byggd för HPC/AI-stackar; integration beror på plattformsval |
Mycket brett stöd för HPC-ekosystem |
Bredast ekosystem av leverantörer/verktyg totalt sett |
|
Typisk sweet spot |
Snäva kollektiv, meddelandetaktstung HPC, blandade AI/HPC-kluster där förutsägbarhet är prioriteringen |
Mycket stora HPC/AI-distributioner med etablerade IB-praxis |
Webbplatser som standardiserar på Ethernet, blandade arbetsbelastningar, eller söker en enhetlig nätverksoperativ modell |
|
Vanlig risk om den väljs dåligt |
Underskattad validering (inte testa verkliga arbetsbelastningsmönster tidigt) |
Kostnads-/tillgänglighetsplanering; designval spelar roll i stor skala |
“Det är Ethernet, det kommer att gå bra”-tänkande, tills PFC-stormar, QoS-gap eller bullriga grannar dyker upp |
Om du vill ha en enkel tumregel: HPC och vetenskaplig AI behöver inte bara snabba länkar; de behöver ett nätverk som förblir stabilt när alla kommunicerar samtidigt.
En praktisk ritning: distribuera CN5000 för europeisk fysik och livsvetenskap
1) Börja med kommunikationsprofilen (inte portantal)
Ställ frågor som:
- Är vi kollektivdominerade (allreduce/alltoall)?
- Är vi begränsade av meddelandehastighet (många små meddelanden)?
- Ser vi prestandaklippor när systemet är belastat?
- Väntar GPU:er på synkronisering?
Detta avgör om du bör optimera för bandbredd, latens, svansbeteende eller en balanserad strategi.
2) Designa för skalningssteg, inte en enda ögonblicksbild
Många europeiska organisationer skalar i faser:
- Pod- eller rack-skala bevis på värde
- Produktion i flera rack
- Tillväxt med flera kluster eller federerad tillväxt
En CN5000-fabricdesign bör återspegla detta från dag ett, inklusive topologi, kablage-strategi, tillväxtportar och operativa gränser.
3) Validera med verklig vetenskap Stanna inte vid mikroriktmärken. Inkludera:
- MPI-kollektiv i avsedd skala
- Mini-appar och representativa kärnor
- AI-träningskommunikationstester (kollektivtunga steg)
- Belastningstester med flera klienter om du kör delad infrastruktur
Målet är att tidigt upptäcka “tysta labbvinster” jämfört med “produktionsverklighetens vinster”, medan ändringar fortfarande är billiga.4) Operationalisera tidigt (eftersom dag 2 är där projekt lyckas eller misslyckas)
Planera för:
- Telemetri och instrumentpaneler (latens, trängselsignaler, länkfel, hotspots)
- Ändringshantering (firmware, konfigurationsavvikelse, kontrollerad utrullning)
- Reservdelar och återhämtningsplanering
Det är här Hammers leverans- och supportmetod kan överbrygga gapet mellan ett snabbt nätverk och en hanterbar tjänst.
Referensarkitekturmönster för europeiska labb och forskningsinstitut
Här är tre vanliga mönster som fungerar bra när man bygger runt CN5000 för fysik- och livsvetenskapsmiljöer
Mönster A: “Science pod” för snabb adoption
- 1–2 rack med beräkning (CPU eller GPU)
- Dedikerad CN5000 leaf-växling
- Tydliga ingress-/egressgränser till lagring och det bredare campusnätverket
- Idealiskt för att bevisa verkliga arbetsbelastningsvinster och utbilda driftteam
Mönster B: Blandat AI + HPC-produktionskluster
- Separata logiska partitioner eller köer för:
- AI-träning
- Simulering
- Datapipelines
- Fabric utformad för att undvika påverkan från bullriga grannar under toppträningskörningar
- Betoning på förutsägbara kollektiv och stabila jobbsluttider
Mönster C: Tillväxt med flera kluster och delade tjänster
- Flera CN5000-baserade kluster (t.ex. bildbehandling inom livsvetenskap, fysiksimulering)
- Delade tjänster:
- Autentisering
- Schemaläggningspolicy
- Övervakning
- Lagring
- Fabricstrategin fokuserar på repeterbarhet: “Vi kan distribuera detta igen med förtroende.”
Det finns ingen enskild “korrekt” design-- det handlar om att du kan anpassa topologin och driftmodellen till hur din organisation faktiskt fungerar.
Datastyrning, säkerhet och samarbete över hela Europa
Fysik och livsvetenskap befinner sig ofta i motsatta ändar av spektrumet för dataförvaltning – från relativt öppen experimentell data inom vissa fysikområden, till mycket känslig mänsklig data inom delar av livsvetenskapen. Modern HPC-nätverksdesign måste erkänna den verkligheten.
När man distribuerar CN5000-baserad infrastruktur i europeiska miljöer är det viktigt att bygga in
- Segmentering genom design (projekt, hyresgäster, reglerade datamängder)
- Granskningsbar ändringskontroll (vem ändrade vad, när och varför)
- Tydliga gränser mot lagring och externa nätverk (minimera överraskande datavägar)
- Beredskap för samarbete (stöd för federerade åtkomstmodeller, där så är lämpligt
Inget av detta är flashigt, men det är ofta skillnaden mellan “ett snabbt kluster” och “en plattform som organisationen kan lita på under de kommande fem åren”.
Vanliga användningsfall där CN5000 + Hammer-leverans kan göra skillnad
AI-träning för vetenskapliga modeller
- Kollektiv, synkroniseringspunkter och burstmönster dominerar
- Förutsägbarhet under belastning är vad som förbättrar tid-till-resultat
Storskalig simulering med synkroniseringspunkter
- Svarstidslatens och jitter kan allvarligt påverka tätt kopplad fysiksimulering
- Meddelandehastighetskapacitet och stabilt beteende spelar roll
Avbildning, rekonstruktion och multi-omics-pipelines
- Arbetsflöden blandar bandbreddstunga steg och kommunikationstunga blandningar
- Körs ofta samtidigt över flera team
FAQ: Hur CN5000 Omni-Path hjälper i verkliga HPC + AI-kluster
Hur förbättrar Cornelis CN5000 Omni-Path HPC- och AI-prestanda i verkliga kluster?
I produktionskluster är genomströmning ofta inte begränsningen, utan trängsel och långsvansad latens. CN5000 är byggd för att hålla kommunikationen förutsägbar under belastning, så att jobb inte träffar “prestandaklippor” när många klienter eller många rankar kommunicerar samtidigt.
Praktiskt taget kommer det från en Omni-Path-design som betonar:
- Lossless behaviour with credit-based flow control (so you don’t fall into loss/retransmit spirals under pressure).
- Finkornig adaptiv routing / multipath för att styra runt tillfälliga hotspots.
- Aktiv trängselhantering (ofta beskriven som switchinformerad pacing/avmattning) för att minska svanseffekter.
Netteffekten: färre stopp i kollektiv- och synkroniseringsfaser, och bättre acceleratorutnyttjande när nätverket är upptaget.
Vilka typer av arbetsbelastningar gynnas mest av CN5000 inom fysik och life science?
CN5000 tenderar att visa sig bäst när jitter och tail-latens dominerar resultaten, särskilt:
- Täta MPI-kollektiv (t.ex. allreduce/alltoall) i stor skala
- Applikationer med hög meddelandefrekvens och många små meddelanden
- Synkroniseringstunga simuleringar där några långsamma ranker drar ner tidssteget
- Burstig eller incast-tung trafik som ses i multi-nod AI-träning, rekonstruktionspipelines och shuffle-tung analys
Om din profilering visar ökad tid i kollektiv, barriärer eller halo-utbyten när du skalar ut, är detta den typ av problem som CN5000 är utformad för att lösa.
Varför blir nätverket flaskhalsen innan GPU:er eller lagring i stor skala?
När kluster skalar, ägnas mer väggtid åt koordinering (gradienter, reduktioner, utbyten, barriärer. När överbelastning eller långsvansfördröjningar uppstår, hamnar de snabbaste noderna och GPU:erna i väntan på de långsammaste kommunikationshändelserna. Utnyttjandet kan kollapsa även om “toppbandbredden” ser stark ut på papper.
Hur skiljer sig CN5000 från InfiniBand eller högpresterande Ethernet (RoCE)?
På en hög nivå:
- CN5000 (Omni-Path): Positionerad som ett end-to-end scale-out-nätverk anpassat för förutsägbar prestanda under belastning, med förlustfritt beteende, adaptiv routing och överbelastningskontroll som förstklassiga designmål.
- InfiniBand: brett använt i toppmodern HPC med ett djupt ekosystem och mogen operativ praxis (utmärkt prestanda, brett leverantörsstöd).
- RoCE / högpresterande Ethernet: Operativt bekant och kapabel till stark prestanda men kräver vanligtvis disciplin kring PFC/ECN-design, buffring, QoS och kontroll av bullriga grannar för att undvika överraskningar i svanslatens i stor skala.
Also worth stating plainly: CN5000’s “full benefits” are typically described as coming from an end-to-end Omni-Path solution (Switches + NICs) rather than mixing-and-matching in the data path.
Vad levererar Hammer faktiskt i ett CN5000-baserat HPC-projekt?
Hammer turns the interconnect into something you can run day to day, typically covering:
- Krav → fabric-design: (topologi, överteckningsmål, tillväxtplan, kabelstrategi)
- Validering: testplaner som speglar verkliga arbetsbelastningar (inte bara tysta labbmikrobenchmarks)
- Bygga och rulla ut: switchar, optik/kablar, värdanslutning, konfigurationsmallar, cutover-stöd
- Drift: övervaknings-/telemetriförväntningar, ändringskontroll, reservdelsstrategi och supportrunbooks
Hur bör vi validera ett CN5000-nätverk innan vi åtar oss en full utrullning?
En praktisk validering före utrullning inkluderar vanligtvis:
- MPI collective tests at intended scale (not just single-rack)
- Mini-appar / representativa kärnor från din faktiska användarbas
- AI-kommunikationstester som belastar kollektivtunga steg (och överlappningsmönster)
- Belastningstester med blandade klienter för att synliggöra effekter av bullriga grannar och långsvansbeteende
Målet: fånga fall där “tysta labbvinster” inte översätts till produktion—medan topologi- och policyändringar fortfarande är billiga.
Hur designar vi ett CN5000-nätverk för stegvis tillväxt över europeiska forskningsplatser?
Många program skalar i faser (pod → multi-rack → multi-cluster/federation). Vanliga designval som gör tillväxten smärtfri:
- Välj en topologi med en tydlig expansionsväg (portar reserverade för tillväxt, förutsägbar kablage)
- Definiera operativa gränser tidigt (klienter/partitioner/köer, QoS-förväntningar)
- Planera hur du hanterar ändringskontroll och “sprängradie” när du lägger till rack eller platser
På så sätt introducerar skalning inte oavsiktligt nya hotspots eller störande granne-beteende
Hur kan CN5000-distributioner stödja datastyrning och säkerhet i hela Europa?
I reglerade life science-miljöer är nätverket en del av kontrollplanet för styrning. Typiska mönster inkluderar:
- Segmentation by project/tenant (so regulated datasets don’t share surprise paths)
- Granskningsbar konfiguration + ändringskontroll anpassad till din säkerhetsmodell
- Tydliga gränser till lagring och externa nätverk för att undvika oavsiktliga datautflödesvägar
- Where collaboration is needed, deliberate federated access patterns rather than ad-hoc peering
Viktiga slutsatser för europeiska forskningsledare
- Nätverket blir alltmer den avgörande faktorn för verklig prestanda inom fysik och life science, särskilt med blandade AI + HPC-arbetsbelastningar.
- Cornelis CN5000 riktar in sig på förutsägbar prestanda i stor skala, där trängselbeteende och svanslatens ofta dominerar jobbets slutförandetid.
- Hammer hjälper till att översätta den förmågan till en fungerande europeisk lösning:
- Designad
- Validerad
- Distribuerad
Driftbar som en tjänst– inte bara en samling högpresterande komponenter Kontakta våra experter idag för att diskutera Cornelis Networks Solutions
Vill du veta mer?